· Atualizado a
Joaquín Trapero in Especialista em inteligência artificial e proteção de dados, e fundador do Nonimo.
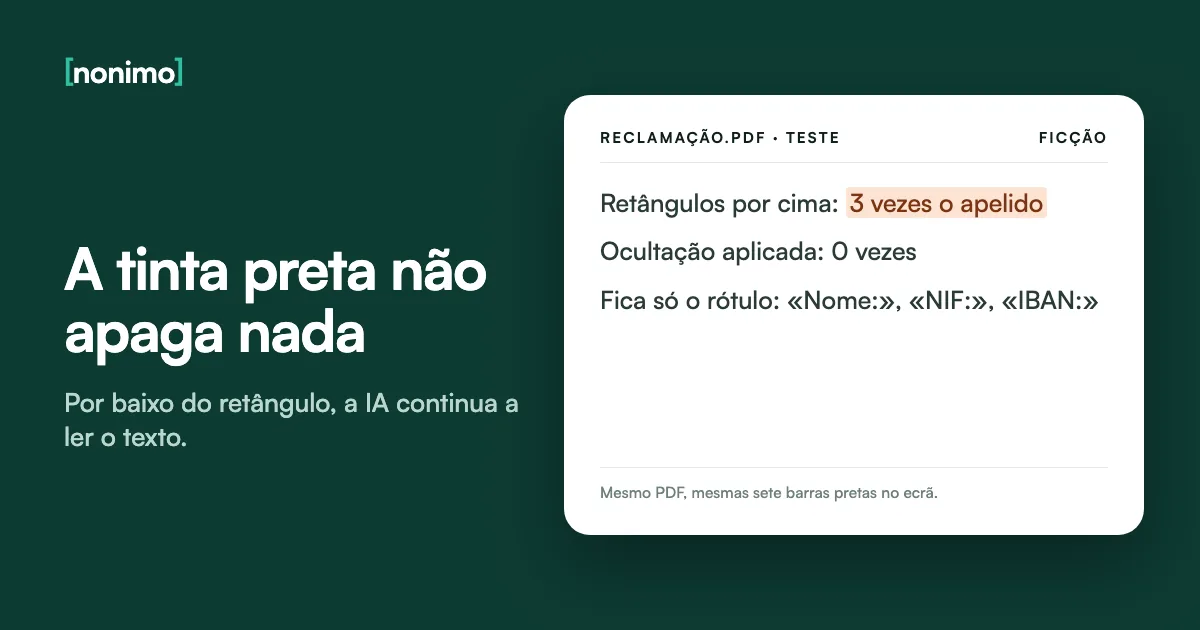
Quem tapa um PDF a preto vê uma página limpa. Um programa vê as palavras intactas por baixo da tinta, e é com um programa que a IA o abre. Acontece na câmara municipal que exporta um requerimento e no escritório que recebe uma contestação.
Aqui separo o que se vê do que fica no ficheiro, e mostro como se remove e se confirma antes de carregar. O que o serviço faz depois à conversa tem um guia sobre o ChatGPT.
Um retângulo preto tapa o ecrã, não o ficheiro: a IA extrai o texto que está por baixo. Remova o conteúdo com uma ocultação aplicada e guardada, ou cole só o excerto já limpo. Antes de carregar, copie a zona tapada e pesquise um apelido. Se aparecer, o dado continua lá.
Retângulo preto num PDF: porque o texto continua lá
Um PDF guarda cada palavra como texto, com o tipo de letra e a posição na página. Por cima podem vir imagens, desenhos e anotações, cada coisa no seu lugar. A barra preta é só mais um desenho: junta tinta e não mexe no que está debaixo.
Daí o engano. No ecrã e na impressora, o resultado parece definitivo. Para um programa que lê o texto do ficheiro, a barra nem existe. Nas folhas de cálculo o engano tem outra forma, a coluna escondida que continua a ser lida.
Das maneiras de tapar, a que acho mais enganadora é o realce preto: usa a ferramenta de sublinhar e tem ar de gesto pensado. Escolha abaixo como foi tapado o seu ficheiro.
Como foi tapado o seu PDF?
Escolha o gesto e veja o que ficou no ficheiro.
Fica tudo. A forma é uma anotação ou um desenho por cima. Qualquer pessoa a seleciona e apaga no leitor, e a extração lê o texto como se ela não existisse.
Fica tudo, e com um comentário em cima. O realce é uma anotação presa às palavras, e quem a remove volta a ler a linha. Que categorias especiais andam nesses papéis vê-se nos papéis de escritório com dados sensíveis.
Fica tudo, noutra cor. Letra branca em fundo branco, ou preta sobre preto, continua a ser texto. Copia-se, pesquisa-se e extrai-se.
Depende do Word. Se a tarja era um retângulo sobre o texto antes de exportar, o PDF herda as duas coisas. Limpe a origem primeiro, pela ordem da página de anonimizar um documento Word.
O texto marcado sai. Fica a barra e, por baixo, nada. É o único gesto desta lista que remove. Converter tudo em imagem também tira a camada de texto, mas só serve se o preto já estiver na imagem, como quando se marca a cópia de uma carta de condução.
O que fica em cada caso deduz-se da estrutura do formato PDF; o primeiro confirmámo-lo no PDF de prova. A Adobe escreve que o marcador preto e a mudança de cor da letra «não são infalíveis».
O nosso teste: sete dados tapados a preto
A prova fizemo-la no fim de setembro, no dia 28. Gerámos um PDF com uma reclamação inventada para os recursos humanos, com sete dados pessoais: nome, NIF, morada, telemóvel, email, IBAN e o nome de uma chefe de divisão. Tapámo-los com retângulos pretos desenhados por cima.
Extraímos depois o texto com duas bibliotecas livres, a pypdf e a PyMuPDF, do género que lê PDF por trás de muitos serviços. Repetimos com a ocultação da própria PyMuPDF, que apaga o que está debaixo da marca, e com uma versão em imagem.
Para quem trabalha com peças processuais, é o mesmo risco descrito no guia de IA para advogados: o documento sai com cara de tratado.
Três versões da mesma reclamação
O que cada ficheiro devolveu à extração e à pesquisa pelo apelido.
| Versão | No ecrã | Texto extraído | Pesquisa pelo apelido |
|---|---|---|---|
| Retângulos desenhados por cima | Sete barras pretas | Os sete dados, por extenso | 3 ocorrências |
| Ocultação aplicada e guardada | Sete barras pretas | Só os rótulos: «Nome:», «NIF:»… | 0 |
| Página em imagem, retângulos por cima | Sete barras pretas | Nada, mas a imagem embutida saiu inteira | 0, por falta de texto |
Resultado da nossa prova: PDF gerado com a reportlab 4.5.0, texto lido com a pypdf 6.10.2 e a PyMuPDF 1.26.5, dados inventados. Os contabilistas encontram o mesmo aviso no guia sobre dados de clientes num assistente de IA.
A primeira linha é a que mais me incomoda: as três versões são iguais à vista, e só uma tirou os dados. A prova que repete o teste em casa não pede nenhum programa novo. Selecione a zona tapada, copie e cole num editor simples, o Bloco de Notas ou o TextEdit.
O editor mostra o texto cru, sem formatação, e serve também para abrir um CSV ou um TXT antes de o enviar. A seguir, Ctrl+F (Cmd+F no Mac) e procure o apelido ou quatro algarismos de um número tapado.
Camada de texto: o que a IA recebe do ficheiro
A documentação para programadores explica-o. A Anthropic escreve que o sistema converte cada página numa imagem e que o texto de cada página é extraído e enviado ao lado dela. Segundo a OpenAI, nos modelos com visão a API extrai o texto e as imagens das páginas e manda as duas coisas.
Juntando ao teste, a conclusão é simples. A imagem da página mostra a barra preta, mas o texto que segue ao lado é o do ficheiro, com o nome por baixo da barra. O que acontece depois ao ficheiro está no guia sobre como o Claude trata os dados.
Quando é uma aplicação a enviar PDFs sem ninguém ao teclado, o ficheiro deixa de ser o único canal, como mostra o guia de fuga de dados com IA.
Dois caminhos a partir do mesmo PDF
O modelo recebe a imagem da página e, ao lado, o texto extraído.
Esquema feito a partir da documentação «PDF support» da Anthropic e «File inputs» da OpenAI; nome inventado. No Microsoft 365, veja também como o Copilot lida com os documentos.
Por isso prefiro, quase sempre, colar o excerto a carregar o anexo. Para rever uma cláusula, a IA precisa da cláusula; para melhorar um diapositivo, não precisa das notas do orador. Três parágrafos colados conferem-se num minuto; um anexo de doze páginas, não.
Se o PDF saiu de um Word revisto a várias mãos, há ainda o que ficou na origem: aceite as alterações controladas e exporte de novo antes de pensar em tapar.
Ocultar no Acrobat Pro sem deixar restos
No Acrobat Pro, a ferramenta chama-se Ocultar e está em Ferramentas. Marca-se o que sai, com duplo clique numa palavra ou arrastando sobre uma área, e depois carrega-se em Aplicar. A página da Adobe em português deixa um pormenor que convém ler devagar: os itens só são removidos de vez quando o documento é guardado.
Para um nome que se repete em vinte páginas há Localizar o Texto e Redigir, que trata uma palavra, uma expressão ou um número no documento inteiro. Não lhe entrego a revisão toda: um apelido sem acento, um NIF escrito em grupos de três ou um nome partido entre linhas escapam a uma pesquisa exata.
Ao aplicar, a caixa Aplicar Ocultações oferece Limpar e Remover Informações Ocultas; a página da Adobe não detalha o que leva. Num ficheiro que vai sair, quero-a ligada. O Acrobat junta «_Ocultado» ao nome e o original fica à parte, o que nos escritórios de advogados evita enviar a versão errada.
Antes de fechar o Acrobat
Marque o que já fez nesta cópia.
0 de 6
Ainda falta um passo. Sem Aplicar e guardar, a marca é só uma marca.
A cópia pode seguir. Guarde o original fora da pasta que partilha.
Lista nossa, montada sobre a página da Adobe. Um gabinete pode juntá-la às suas regras internas sobre IA.
Num cartório, onde a minuta passa por várias mãos e o sigilo do notário a cobre por inteiro, esta lista cabe num post-it. Colada no monitor, faz mais do que uma circular.
PDF digitalizado: a imagem também chega à IA
Um digitalizado é uma fotografia de cada página dentro de um PDF. Sem reconhecimento de texto, copiar não devolve nada, e a IA não fica às escuras: recebe a imagem de cada página. A carta de condução digitalizada lê-se tão bem como a original.
Um retângulo desenhado sobre um digitalizado tem a mesma falha que no PDF de texto. No nosso teste, a imagem extraída de dentro do ficheiro saiu inteira, sem uma barra. E se no leitor consegue selecionar palavras da página, o ficheiro tem também texto, e esse texto comporta-se como o da primeira linha da tabela.
Num digitalizado, dou por não tapado tudo o que esteja pousado sobre a imagem. Ou se apagam os píxeis, ou se transcreve à mão só o parágrafo útil. Depois de carregado, o ficheiro fica no serviço pelos prazos que o guia sobre o que as IA guardam dos ficheiros compara.
O que fazer com este digitalizado?
Três perguntas sobre o seu ficheiro.
No leitor, consegue selecionar uma palavra da página?
A IA precisa da página inteira, ou de um parágrafo?
A página é um documento de identificação?
Triagem nossa. Relatórios e análises que chegam digitalizados a uma clínica pedem esta triagem antes de qualquer IA.
Se a cópia tiver de seguir para alguém, o traço com o destinatário numa cópia do Cartão de Cidadão grava-se na imagem e não se levanta. Num digitalizado, é a única marca em que confio.
Formulários, anexos e metadados do PDF
Um requerimento ou uma declaração em PDF pode chegar como formulário para preencher no computador. O que se escreve nos campos fica guardado como valor do campo, e uma barra por cima da página não lhe toca. É aqui que eu desconfiaria primeiro, porque o formulário parece fechado e não está.
Há ainda o que não aparece na página: propriedades, anexos, comentários e a assinatura digital. A aplicação Autenticação.gov assina PDF com o certificado do Cartão de Cidadão, e pode juntar-lhe Motivo ou Localização. Uma barra por cima da página não tira a assinatura do ficheiro.
Para as propriedades, há um guia só para elas, no Word e no PDF. Filtre abaixo pelo que se vê ou não no ecrã.
O que um PDF leva além da página
E o que fazer antes de o carregar.
| Elemento | Onde está | O que fazer |
|---|---|---|
| Campos de formulário preenchidos | Nos campos, como valor | Apagar o valor ou copiar só o texto para um documento novo |
| Assinatura digital | No ficheiro, ligada ao certificado de quem assinou | Não carregar o original assinado; enviar uma cópia de texto |
| Comentários e notas | Nas anotações | Apagá-los um a um e confirmar que o painel ficou vazio |
| Propriedades do ficheiro | Autor, título, programa, datas | Ver em Propriedades do documento e limpar |
| Anexos | Ficheiros embutidos no PDF | Abrir o painel de anexos e retirá-los |
Ações que sugerimos; a assinatura com o certificado do Cartão de Cidadão, Motivo ou Localização é descrita pela Autenticação.gov. A assinatura entra nas duas vistas porque alguns leitores de PDF não a reconhecem, como avisa a mesma página. Num gabinete de contabilistas certificados, vale a pena correr esta tabela em cada declaração recebida.
Expurgar documentos: o que pede a CNPD
A CNPD não tem, que tenhamos encontrado, uma deliberação sobre um PDF mal tapado. Tem duas orientações de abril de 2023 que usam o verbo certo, expurgar, e assentam na minimização do artigo 5.º do RGPD. Se um PDF mal tapado já seguiu, a pergunta passa a ser se é preciso notificar a CNPD.
A de 11 de abril trata de procedimentos administrativos: manda ocultar ou expurgar a morada, os contactos e o número de identificação civil. Lembra ainda que uma certidão do registo criminal pode trazer um crime sem relação com o concurso.
A de 18 de abril, sobre atas na Internet, avisa que tirar o nome não basta para anonimizar: há mais do que o nome a identificar. O verbo vinha da Lei n.º 26/2016, que comunica em parte o documento administrativo quando se pode expurgar a matéria reservada (art. 6.º, n.º 8).
Duas orientações da CNPD e o que dizem a quem tapa um PDF
Pontos citados e a leitura deste guia.
| Orientação | Ponto | O que diz | No PDF |
|---|---|---|---|
| 11 de abril de 2023 | 12 e 17 | Expurgar a morada, os contactos e o n.º de identificação civil; nos trabalhadores, também o fiscal | Esses campos saem do ficheiro, não só da vista |
| 11 de abril de 2023 | 19 | Plataformas desenhadas para ocultar automaticamente, por força do artigo 25.º do RGPD | A ocultação faz parte do processo, não é um retoque |
| 18 de abril de 2023 | 16 | A anonimização não se faz só por expurgo ou ocultação do nome | Rua, cargo e datas também identificam |
CNPD, orientações aprovadas a 11 e 18 de abril de 2023. Para escolher o assistente, ver que IA aguenta uma leitura à luz do RGPD. É uma ajuda de leitura; um caso concreto pede o seu jurista.
Estas orientações foram escritas para serviços públicos, e quem trabalha numa autarquia tem a análise de o que um serviço autárquico pode levar a uma IA. Leio-as como uma regra prática para qualquer PDF: um expurgo que se desfaz com copiar e colar não expurgou nada.
Trocar o nome por uma etiqueta mantém o sentido para a IA, mas não torna o texto anónimo: o RGPD chama-lhe pseudonimização, e o guia sobre esse conceito explica porque continua a haver dados pessoais.
Um PDF limpo para a IA, com o Nonimo
A ferramenta acima recebe o PDF no nosso servidor, oculta os dados que reconhece e mostra a pré-visualização com a lista «O que foi ocultado», onde pode desmarcar um tipo. Em «Descarregar» escolhe PDF, Word ou TXT. O ficheiro não fica guardado no servidor; os pormenores estão no aviso de privacidade.
Como trabalha sobre o texto e não sobre o desenho da página, a barra preta deixa de ser a questão, e a mesma pessoa recebe sempre a mesma etiqueta. É prevenção barata: um seguro de riscos cibernéticos só cobre parte de um incidente, e conforme a apólice.
Para um digitalizado ou um processo com sigilo, a app lê o ficheiro no computador, em Mac e Windows; a página de segurança explica como.
A linha da reclamação, antes e depois
O texto que a IA extrairia do PDF tapado, e o que recebe com etiquetas.
Extraído do PDF tapado a preto
Eu, Clementina Arez Fontoura, com o NIF (nove algarismos), residente na Rua do Exemplo, Viseu, reclamo da avaliação do Dr. Simão Fragoso Leal.Com as etiquetas
Eu, [PESSOA_1], com o NIF [NIF_PT_1], residente na [MORADA_1], reclamo da avaliação do Dr. [PESSOA_2].Reclamação inventada, com etiquetas de exemplo escritas à mão. Para instalar a app numa equipa, há instruções em Organizações.
Daqui só aceito duas saídas: o excerto já com etiquetas, ou a cópia ocultada que passou na prova da pesquisa. Tapado à mão e nunca pesquisado, não sai. Para o dia a dia, o Nonimo troca os dados do PDF por etiquetas no seu computador e repõe os nomes na resposta.
Fontes
- Adobe, Como ocultar texto em ficheiros PDF?: marcador preto e cor da letra «não são infalíveis»; Ferramentas, Ocultar, Aplicar; opção Limpar e Remover Informações Ocultas na caixa Aplicar Ocultações; Localizar o Texto e Redigir; remoção definitiva só ao guardar; sufixo «_Ocultado».
- Anthropic, PDF support: cada página é convertida numa imagem e o texto extraído segue ao lado.
- OpenAI, File inputs: nos modelos com visão, a API extrai o texto e as imagens das páginas e envia os dois.
- CNPD, Orientação sobre a disponibilização de dados em procedimentos administrativos: aprovada a 11 de abril de 2023, pontos 12, 17, 18 e 19.
- CNPD, Orientação sobre a publicação na Internet das atas de órgãos colegiais: aprovada a 18 de abril de 2023, ponto 16.
- Regulamento (UE) 2016/679, texto em português no EUR-Lex: o princípio da minimização (artigo 5.º) e a proteção de dados desde a conceção (artigo 25.º).
- Lei n.º 26/2016, Diário da República: acesso aos documentos administrativos; comunicação parcial com expurgo da matéria reservada (art. 6.º, n.º 8).
- Autenticação.gov, Assinatura digital com o Cartão de Cidadão: assinar PDF na aplicação com o certificado do cartão, validade de assinatura manuscrita, opção de Selo Temporal, Motivo ou Localização.
Consultadas em 10/11/2026.
Guias relacionados
Perguntas frequentes
Como ocultar dados num PDF?
Removendo o texto, não pintando por cima. No Acrobat Pro, marque com Ocultar, carregue em Aplicar e guarde. Depois copie a zona tapada e pesquise um apelido: se nada aparecer, o dado saiu.
Um retângulo preto apaga o texto de um PDF?
Não, só o esconde no ecrã. A forma é desenhada por cima e o texto fica por baixo, intacto. No nosso PDF de teste, duas bibliotecas de extração leram os sete dados tapados.
Como saber se um PDF tapado ainda tem o texto?
Copie a zona preta e cole-a num editor simples. Depois procure com Ctrl+F um apelido que tapou. Se a cópia ou a pesquisa o devolverem, o dado continua no ficheiro.
Uma IA consegue ler um PDF digitalizado?
Sim, porque recebe imagens das páginas. A Anthropic e a OpenAI descrevem que enviam ao modelo a imagem de cada página, além do texto que houver. Uma digitalização sem texto continua legível.
Como ocultar texto num PDF sem o Acrobat Pro?
Copie só o excerto de que precisa para um documento novo e tire-lhe os dados. Para o ficheiro inteiro, use a ferramenta lá em cima, que o trata no servidor, e confirme o resultado com a prova de pesquisa.
A ocultação do Acrobat tira os metadados do PDF?
A página da Adobe não o diz. A caixa Aplicar Ocultações traz à parte a opção Limpar e Remover Informações Ocultas. Ligue-a e confirme depois, em Propriedades do Documento, o que ficou.